Codexで請求書PDFをまとめて取得。保存4件・失敗6件を照合した
請求書を1件ずつ開き、ダウンロードして、決まったフォルダーへ保存する。電子化しても、この操作が残ることがあります。
Dignowaでは、架空の請求書を配信するサーバーをこのPC上に作り、Codexで取得処理を実装・実行しました。重複を除いた12件のうち、PDF4件を保存。6件はエラーとして残し、取消と対象月違いの2件は取得対象から除外しました。
この記事はDignowa編集部による実験報告です。実装・実行はCodexが担当しています。実在の請求書サービスへのログインや画面操作を自動化した結果ではありません。今回は、自作の配信先からHTTPで取得する部分を検証しました。
100件のPDFを、100回クリックしていた事例
Coopelが公開するDeNAの事例には、電子請求書を100件ダウンロードするために、ボタンを100回押していたという説明があります。ページの表示日は2020年5月15日です。現在のサービスに一括取得機能がない、という根拠には使いません。
DeNAはDignowaの顧客ではありません。今回の配信先とPDFは、公開された業務課題を参考に独自に作ったものです。出典にある作業時間の削減を、今回の成果としては扱いません。
一覧は13行でも、請求書は12件だった
検証用の一覧は3ページに分け、合計13行を配信しました。同じ請求書を1行重複させているため、請求番号で整理すると12件です。このうち1件は取消、1件は対象の9月とは違う8月の請求書にしました。
対象となる10件の取得先には、正常なPDFに加え、通信エラー、空ファイル、途中で切れたPDF、請求番号が違うPDFなどを用意しました。例外を含む条件はこちらで設定しています。
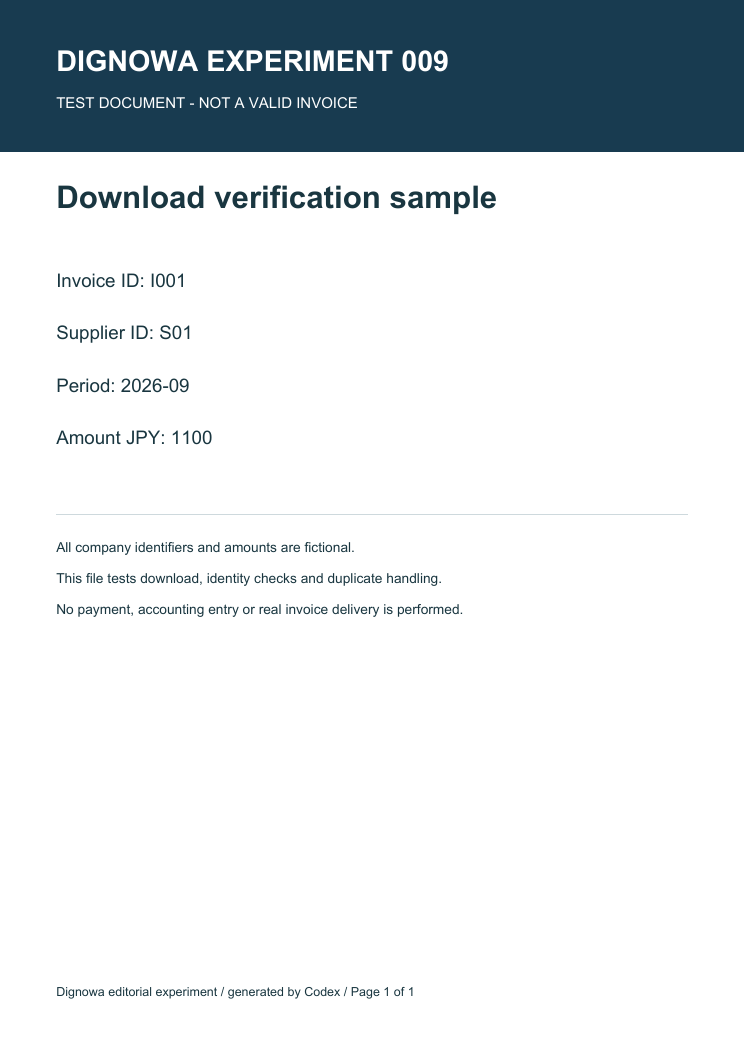
PDFの中身は、請求番号、仕入先ID、対象月、金額が書かれた1ページの架空帳票です。実際の請求や支払いに使わないよう、検証用であることを表示しました。
同じ「invoice.pdf」に保存すると、1件目が消えた
配信側は、どの請求書にも「invoice.pdf」という同じ保存名を返すようにしました。比較用の処理でI001とI002を順に同名で保存すると、最後に残ったのは1ファイルだけです。本文を読むとI002で、I001は上書きされていました。
完成版では、一覧の情報から「2026-09_S01_I001.pdf」のように対象月・仕入先ID・請求番号を含む名前を付けました。保存後に請求番号と本文を照合できる形です。
これは意図的に不十分な保存方法と比べた検証です。顧客の請求書を消した話でも、今回の完成版で起きた事故でもありません。
通信が成功しても、PDFとは限らなかった
I003の取得先は、通信上の成功を示すHTTP200を返します。ファイルの種類もPDFと名乗りますが、中身は架空のログイン画面のHTMLです。通信の成功だけを見る比較では、そのHTMLも取得できてしまいました。
完成版では、PDFの先頭部分を確認し、pypdfで開けることも確かめてから保存します。I003はPDFとして保存せず、エラー一覧に残せました。実際にログインが切れたサービスを操作したわけではなく、そうした応答を模した条件です。
I007はPDFとしては開けますが、一覧の請求番号と本文の請求番号が違います。このファイルも保存対象から外しました。今回の帳票では、請求番号・仕入先ID・対象月・金額の4項目を一覧と照合しています。
保存できた4件と、残った6件のエラー
正常なI001、I002、I008に加えて、一度失敗したI005も保存できました。I005は最初にHTTP503を返す設定です。2回目にはPDFを返すため、再試行で取得できています。
| 請求番号 | 実際の結果 | 今回の処理 |
|---|---|---|
| I003 | PDFを名乗るHTML | PDFではないとして停止 |
| I004 | HTTP500が継続 | 2回まで試してエラーに記録 |
| I006 | 途中で切れたPDF | PDFとして開けず停止 |
| I007 | 本文の請求番号が違う | 一覧との不一致で停止 |
| I011 | 本文が空 | PDFではないとして停止 |
| I012 | 別URLへの移動指示 | 自動で移動せず停止 |
初回のPDF取得要求は、再試行を含めて12回です。取消のI009と、対象月が違うI010には取得要求を送っていません。取得できなかった6件があるため、処理の終了を「全請求書を保存できた」とは扱っていません。
2件保存したところで止め、続きから再開した
次に、2件を保存した時点で処理を意図的に止めました。保存済みのファイルと記録を残したまま再開すると、先の2件を再取得せず、残り2件を追加で保存できました。最終的な4件のPDFは、通常の実行で保存したものと完全に一致しています。
この試験は、用意した停止機能を使ったものです。書き込み中に電源を切った場合や、OSが強制終了した場合まで確かめたわけではありません。
通常の再実行でも、取得済み4件を再ダウンロードしないことを確認しました。保存後にPDFを書き換えた条件では、記録したハッシュとの違いを検出し、上書きせずエラーとして残しています。
CodexとPythonで、どこまで確かめたか
Codexが取得と検査のコードを作り、Pythonで配信サーバーと取得処理を動かしました。通信には標準のurllib.request、PDFの作成にはReportLab、本文の確認にはpypdfを使っています。生成AIは開発・実行の支援に使い、請求ごとの採否は決めたルールで判定しています。
CLIを5回実行し、件別の結果、再試行回数、対象外のファイルに要求を送っていないこと、再実行と再開を含む33の検査を通過しました。保存した4PDFは配信元とバイト単位で一致し、本文の4項目も期待値と照合しています。画像に変換して、4冊の表示も確認しました。
今回は自然に起きた実装エラーは記録されていません。同名保存での上書きやHTMLの応答は、意図して設けた比較・検査条件です。実在サービスの障害を観測した結果とは区別しています。
実際の請求書サービスに使う前に
今回の取得先は、この検証の間だけ動かしたローカルサーバーです。実サービスのログイン、認証の更新、画面のクリック、一括取得APIへの接続は未検証です。実務では、利用中のサービスに一括ダウンロードや公式APIがあるかを先に確認します。
本文の照合も、今回作った1ページの文字PDFに限っています。スキャン画像、複数ページ、パスワード付きのPDFや、仕入先ごとに書式が違う請求書は別の検証が必要です。金額を一覧と照合したことは、請求内容そのものが正しいという証明ではありません。
通信エラーの再試行は最大2回とし、実験では待ち時間を設けていません。実際の接続先では、要求回数の制限や再試行までの待ち時間に合わせる工程が残ります。
今回確認できたのは、決めた取得方式でPDFを集め、保存できたものと確認が必要なものを分けるところまでです。実際の月初業務で何時間減らせるかは、まだ測っていません。
保存したPDFと実行記録
12件の結果一覧と保存したPDFを掲載しました。すべて架空データです。取得のHTTP記録や、再開前後の結果もコード・入力・実行記録のZIPに含めています。
検査結果JSONと初回の取得結果JSONでは、保存4件、失敗6件、対象外2件の内訳を確認できます。検証用サーバーは実行後に停止しています。