「白キャップ2箱」を何個と読む?Codexで注文書30枚をOCRに通してみた
Codexで業務改善・002|Dignowaのダミーデータ検証|2026年10月4日
「白キャップ、2箱お願いします」
商品名も数も書いてあるし、そのまま入力すればよさそうです。でも、1箱が50個入りなのか、24個入りなのか。同じ呼び方でも、取引先によって指している商品が違ったらどう扱えばよいのでしょうか。
今回は、注文書にある略称と数量単位を扱う実験です。Dignowaで架空の注文書画像を30枚作り、文字を読み取って、取引先別の対応表と照合するところまで実行しました。開発と実行検証はCodexが担当しています。
結果から書くと、品番と数量の候補ができたのは9枚。残る21枚は確認が必要として止まりました。わざと不備を入れた注文もありますが、正常な注文でも読み取りに失敗しています。
「画像から読めたら終わり」にはならなかった。その中身を残しておきます。
略称や単位の確認は、実際にあった仕事
きっかけは、インフォマートが公開している大和物産株式会社の事例でした。FAXの文字や商品の単位を電話で確認したり、略称の意味を営業担当に聞き直したりする業務が紹介されています。同社はTANOMUやFAX-OCRを導入して改善しています。大和物産株式会社の導入事例
この企業をDignowaが支援したわけではありません。公開されている課題をもとに、別の構成と架空の商品で試しています。「白キャップ」は今回の実験用に作った例です。
試したかったのは、商品名らしい文字を拾うことだけではなく、正式な品番と個数の候補に直し、決められないものを確認へ戻すところです。
Codexで作った処理と、使った道具
Codexで、注文書のPNG画像を読み、確認用の一覧を出す小さなプログラムを作りました。
文字の読み取りには、このPCに入っていたWindowsのOCRを使いました。日本語の認識機能があることを確認し、PowerShellから呼び出しています。読み取った文字を整理し、商品辞書と照合する部分はPythonです。MicrosoftのOCR機能の説明
生成AIを使ったのは、処理の実装と検証を進める部分です。注文を処理するたびに、生成AIに似た商品を選ばせる構成にはしていません。ここでは、取引先と略称が対応表に一致した場合だけ候補を出します。
開発をCodex中心に進めるAI駆動開発でも、実際の処理に使う道具は分かれます。今回なら、文字を読むのがWindows OCR、照合するのがPython、担当者が確認するのがブラウザーの一覧です。有料OCRのAPIは使っていません。
同じ「2箱」でも、100個と48個に分かれる
架空の対応表には、取引先C001の「白キャップ」を品番P010、1箱50個と登録しました。取引先C002の同じ略称は、品番P020、1箱24個です。
そのため、どちらも「白キャップ2箱」でも、C001なら100個、C002なら48個になります。実際の画像を読み込ませた結果も、この二つは期待した候補になりました。
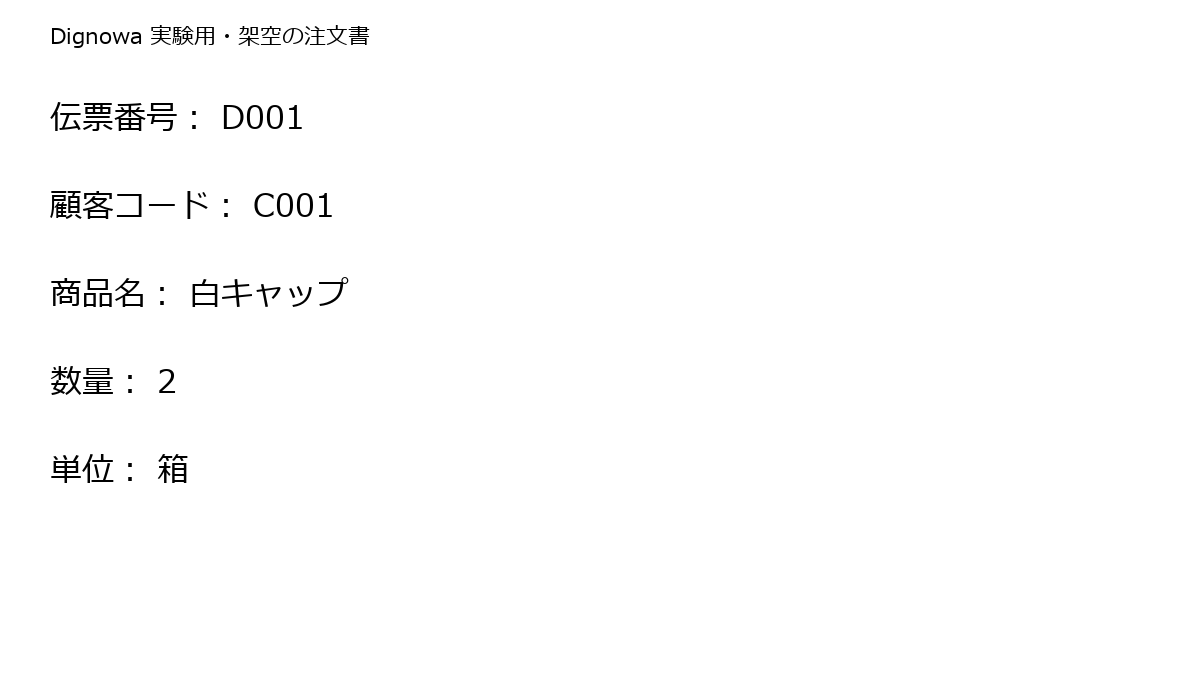
対応表には「白フタ」という別名も入れました。一方、「いつもの」は登録せず、「白容器」には二つの品番を登録。対応がない場合と、複数あって一つに決まらない場合を、別々に確認できるようにしています。
数量もそのまま掛け算すればよいわけではありません。0、マイナス、小数、未登録の単位を入れて試しました。今回の試作では数量を正の整数に限定し、換算後1,000個を超える行は確認へ戻しています。この上限は実験用の仮ルールです。
正常な注文でも、3枚は候補を作れなかった
30枚の内訳は、通常の印字で内容も正常な12枚、略称や数量などに不備を入れた14枚、傾き・低解像度・ぼかし・白紙化を試した4枚です。実際に届いたFAXではなく、Pythonで作った固定レイアウトの画像です。
| 入れた画像 | 枚数 | 実際の結果 |
|---|---|---|
| 通常の印字・内容が正常 | 12 | 9枚で候補を作成。3枚は数量を取り出せず停止 |
| 未登録の略称、複数候補、数量・単位などの不備 | 14 | 14枚とも候補を確定せず確認へ戻した |
| 傾き、低解像度、ぼかし、白紙化 | 4 | 4枚とも必要な項目がそろわず停止 |
正常な3枚で何が起きたかというと、OCRが「数量」と「12」を別々の行として返していました。今回のプログラムは「数量と値が一つの行にある」という条件で項目を取り出すため、数量なしと判断しています。
元画像には数字がある。それでも、文字の読み取り結果を業務の項目へ戻す途中で止まることがあるわけです。
この段階で「注文書を自動処理できました」とだけ書くと、実態が伝わりません。今回できたのは、9枚で品番・個数の候補を作り、それ以外を理由付きで確認一覧へ残すところまでです。
5項目すべてが正解データと一致した画像は17枚でした。これは伝票番号・顧客コード・商品名・数量・単位を一組として比べた件数です。注文の内容が不適切な画像も含むので、候補ができた9枚とは数え方が違います。
辞書に合えば正しい、とは言えない
候補ができた9枚については、品番と換算数量が実験用の正解と一致しました。ただ、それだけで誤読を防げるとは言えません。
別の検証で、読み取った顧客コードをC001からC002に置き換え、同じ照合処理へ渡してみました。これはOCRが実際に間違えた例ではなく、誤読を想定して文字を変えた試験です。
結果は、P020・48個という候補になりました。C002も登録済みなので、対応表との照合だけでは間違いに気づけません。
だから今回の一覧は、候補がある9枚も含めて全件「原本照合待ち」にしています。注文を確定した件数は0件。発注や外部システムへの送信も行っていません。
略称・数量のルールは、OCRとは分けて29項目を検査しました。候補が複数ある場合、入数の設定が0の場合、同じ項目が複数出た場合などです。これらの検査は通りましたが、実際の画像で起きた読み取り失敗を打ち消すものではありません。
Dignowaで次に直すなら
まず直したいのは、数量が別の行になった3枚です。固定の帳票なら、文字の位置や入力欄ごとに読む方法を試せます。帳票が取引先ごとに違うなら、帳票用OCRと同じ原本で比較し、どこまで項目を取り出せるか確認したいですね。
あわせて、担当者が原本を見て修正し、確認済みとする操作も必要です。今回作ったのは確認一覧までで、その承認操作はまだ実装していません。
この実験では、手書き、実FAXの汚れ、複数明細、現場での確認時間は検証していません。電話確認が何件減るかも測れていません。
ただ、取引先別の略称と入数をそろえれば、同じ「2箱」を100個と48個に分ける処理は作れました。その手前の読み取りでどこが止まるのかも、実際に画像を通すことで分かっています。
実験の画像、OCRの原文、30枚分の結果、再現用のコードを残しました。うまく読めなかった注文書も、そのまま入っています。